返回项目列表
OpenClaw 研发运营 Agent logo

Project 02

OpenClaw 研发运营 Agent

以企业微信为统一入口,设计自然语言查询与 AI 自动化工作流。接入数据库、Git、K8s 等多数据源,实现 Git 提交统计、开发数据查询、部门周报生成等效率工具。

AI 产品实习生
2026.03 - 2026.04
AI 工具企业效率

01 · 业务阶段

业务背景

径硕科技内部,运营团队需要频繁查询研发数据(Git 提交、K8s 部署状态、数据库信息等),但这些数据分散在不同系统中,需要找对应负责人查询,沟通成本高、效率低。项目的目标不是做一个酷炫的AI工具,而是把运营人员从"找研发要数据"的低效沟通中解放出来,让数据获取像发消息一样简单。

02 · 业务阶段

原来的业务流程

1运营人员产生数据需求
2在企业微信找对应研发人员
3描述需求背景和数据要求
4研发人员登录对应系统查询
5整理数据后回复运营
6数据不对/不够 → 反复沟通
7最终拿到可用数据

03 · 业务阶段

发现什么问题

  • 数据孤岛:研发数据分散在 Git、K8s、数据库等多个系统,运营人员无法自助查询
  • 沟通成本高:每次数据查询都要找对应研发人员,平均耗时 30 分钟以上
  • 重复性报表:部门周报、项目进度统计等重复性工作占用大量人力
  • 工具门槛高:专业工具(Git CLI、SQL 等)对非技术人员不友好

04 · 业务阶段

为什么值得解决

用户层面:运营人员不需要学习复杂的技术工具就能拿到数据。效率层面:每次查询从30分钟缩短到几十秒,释放研发和运营双方的时间。组织层面:数据不再是研发部门的"私产",而是可以被业务人员自助获取的公共资源。核心判断:企业效率工具的价值不在于技术有多酷,而在于它是否能真正降低跨部门协作的摩擦成本。

05 · 用户阶段

用户是谁/用户场景

运营经理

需要查看部门研发数据、生成周报,高频使用

产品经理

需要了解功能开发进度、上线状态,中频使用

项目负责人

需要跟踪项目进展、团队产出,中频使用

HR/行政

偶尔需要查询员工产出数据,低频使用

06 · 用户阶段

需求分析

用户任务对应能力
查Git提交数据Git仓库数据查询能力
查部署状态Kubernetes集群状态查询
查业务数据数据库SQL查询能力
生成周报多源数据聚合 + LLM总结
团队效率分析数据统计与可视化
异常告警规则引擎 + 消息推送

07 · 产品阶段

为什么选择AI

因为企业内部的数据查询需求是高度多样化和非结构化的。运营人员不会说"帮我查一下git log --author=xxx --since=2026-03-01 --until=2026-03-31 --stat",他们会说"帮我看看张三这个月提交了多少代码"。如果用传统后台,需要为每一种查询场景开发一个页面和表单,开发成本高、覆盖场景有限。而LLM可以理解自然语言意图,自动生成对应的查询语句,用一个入口覆盖几乎所有查询场景。

08 · 产品阶段

产品方案架构

整体架构:企业微信入口 → 自然语言输入 → 意图识别与工具路由 → 工具执行层(Git API / K8s API / SQL查询) → 数据聚合 → LLM自然语言总结 → 结果返回。核心原则:LLM做决策(理解意图、生成查询语句、汇总结果),工具做执行(实际数据查询、系统操作),确保数据准确性和安全性。

09 · 产品阶段

Agent Workflow

1

意图解析:理解用户自然语言查询需求,识别目标数据源

2

工具选择:根据意图选择对应工具(SQL 查询 / Git API / K8s API)

3

参数生成:生成查询语句或 API 参数

4

数据获取:调用工具执行查询,获取原始数据

5

结果汇总:将多源数据整合,生成结构化结果

6

自然语言输出:以用户易理解的方式呈现结果和图表

10 · AI技术阶段

RAG/知识库/Prompt

  • Schema知识库:存储数据库表结构、字段含义、Git仓库信息等元数据
  • 查询示例库:常见查询的最佳实践示例,用于few-shot prompting
  • Prompt设计:明确输出格式要求,确保SQL/API参数正确无误
  • 安全约束:禁止执行写操作、禁止访问敏感表、设置查询超时
  • 错误处理:查询失败时自动分析错误原因并重试或转人工

11 · 验证迭代阶段

四层效果评估体系

AI层

意图识别准确率SQL生成正确率查询结果相关性

Agent层

任务完成率平均查询耗时人工干预率

产品层

日活用户数人均查询次数功能使用率

商业层

节省人力时间运营效率提升研发沟通成本降低

EVIDENCE · 产品证据

MY CONTRIBUTION

我的贡献

我主要负责

  • 业务需求调研与场景识别:深入运营团队,梳理高频查询需求并排序优先级
  • Agent 产品方案设计:定义 6+ 工具的调用场景、输入输出协议和验收标准
  • Workflow 设计:设计意图解析 → 工具路由 → 结果聚合的完整流程
  • Prompt / Schema 知识库设计:定义数据库表结构、字段含义等元数据
  • 测试与效果验证:设计四层评估体系,跟踪 AI/Agent/产品/商业指标
  • 根据用户反馈推动迭代:建立点赞/点踩反馈闭环,优化查询成功率

研发协作

研发团队负责底层 Tool/API 实现(Git、K8s、SQL 执行引擎);我的职责是定义工具能力边界、输入输出协议、调用场景和验收标准

VALUE MAPPING

价值-场景映射

业务价值实际场景产品能力结果
降低技术门槛数据库记录查询自然语言 → SQL 生成运营无需学习 SQL
降低沟通成本K8s 部署状态查询K8s Tool 自动调用无需找研发查状态
提升响应速度K8s + DB 混合查询多工具并行编排秒级返回多源数据
减少重复劳动部门周报生成多源聚合 + LLM 总结2h → 5min

PRODUCT EVIDENCE

真实使用场景

1

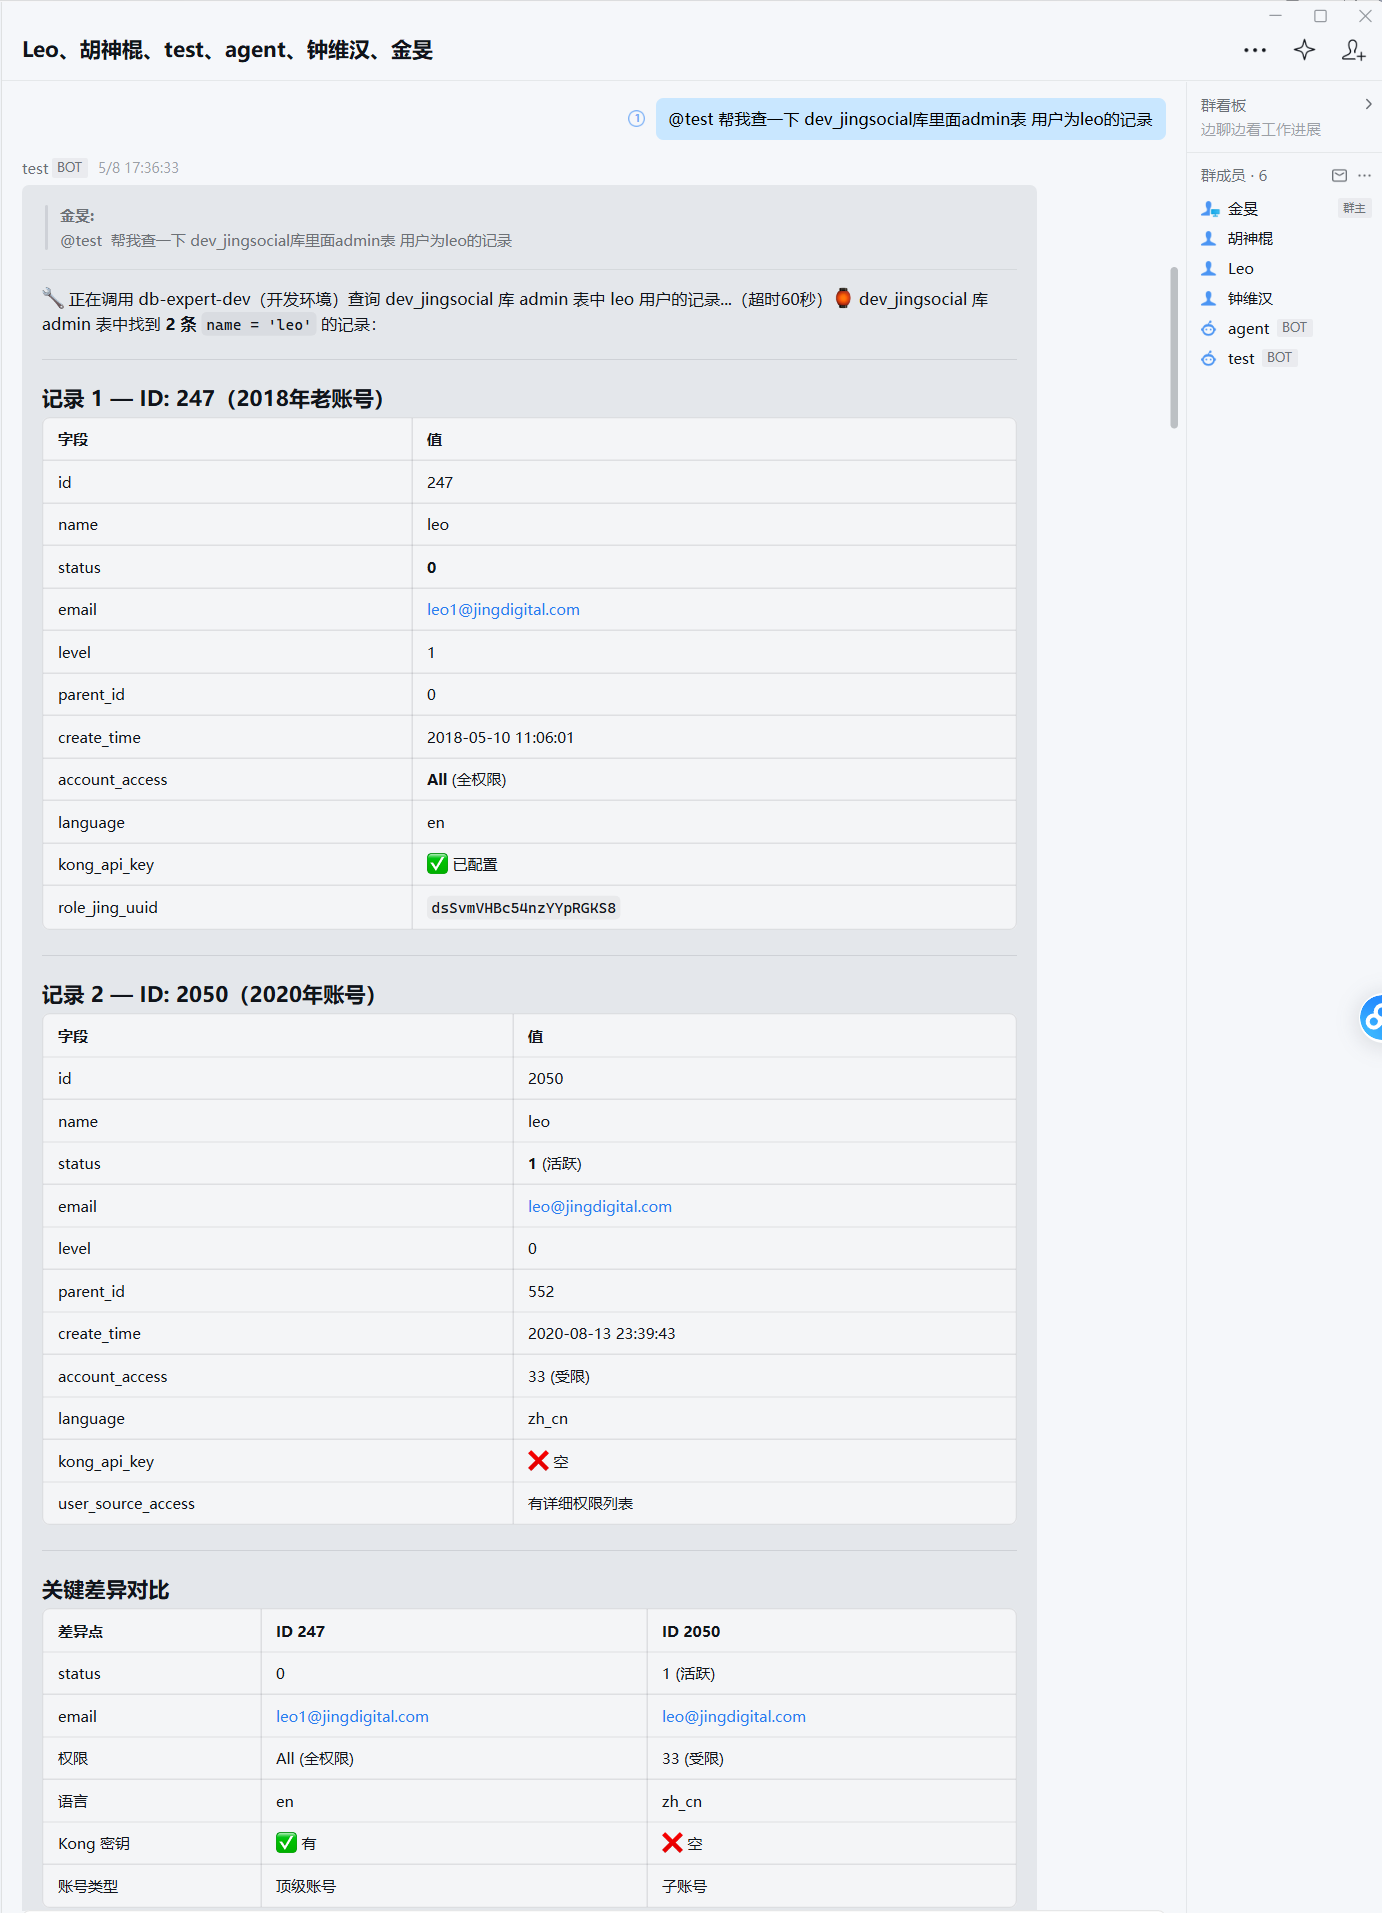
场景 01|数据库表记录查询

运营人员通过企业微信直接查询业务数据库,Agent 自动解析表结构并返回结构化结果。

① 用户问题

“@test 帮我查一下 dev_jingsocial 库里面 admin 表 用户为 leo 的记录”

② 用户原来的解决方式

运营在企业微信找研发 → 研发登录数据库 → 手动写 SQL → 查询 → 整理结果 → 回复运营(平均耗时 30 分钟+)

③ Agent 如何解决

1意图识别:解析"查 admin 表 leo 的记录"为数据库查询意图
2Schema 检索:从知识库获取 admin 表结构定义
3SQL 生成:生成 SELECT 语句,WHERE user = "leo"
4安全校验:确认为只读查询,执行权限检查
5SQL 执行:调用数据库 Tool 执行查询
6结果结构化:将原始数据转为表格 + 差异对比
7自然语言总结:附上关键差异说明返回企业微信
场景 01|数据库表记录查询

④ 为什么这个场景适合 AI

用户表达的是"帮我看看 Leo 的账号状态"而不是"请执行 SELECT * FROM admin WHERE..."。传统后台需要为每种查询开发表单页面,而 LLM 能理解自然语言意图、自动生成 SQL,一个入口覆盖几乎所有查询场景。

⑤ 最终结果

返回 2 条 admin 表记录(ID: 247/2050),含字段值、状态、创建时间、权限等级,并自动生成关键差异对比表

2 条记录返回 / 约 10 秒(含意图识别 + SQL 生成 + 执行 + 总结)

数据库SQL 查询结构化输出差异对比
2

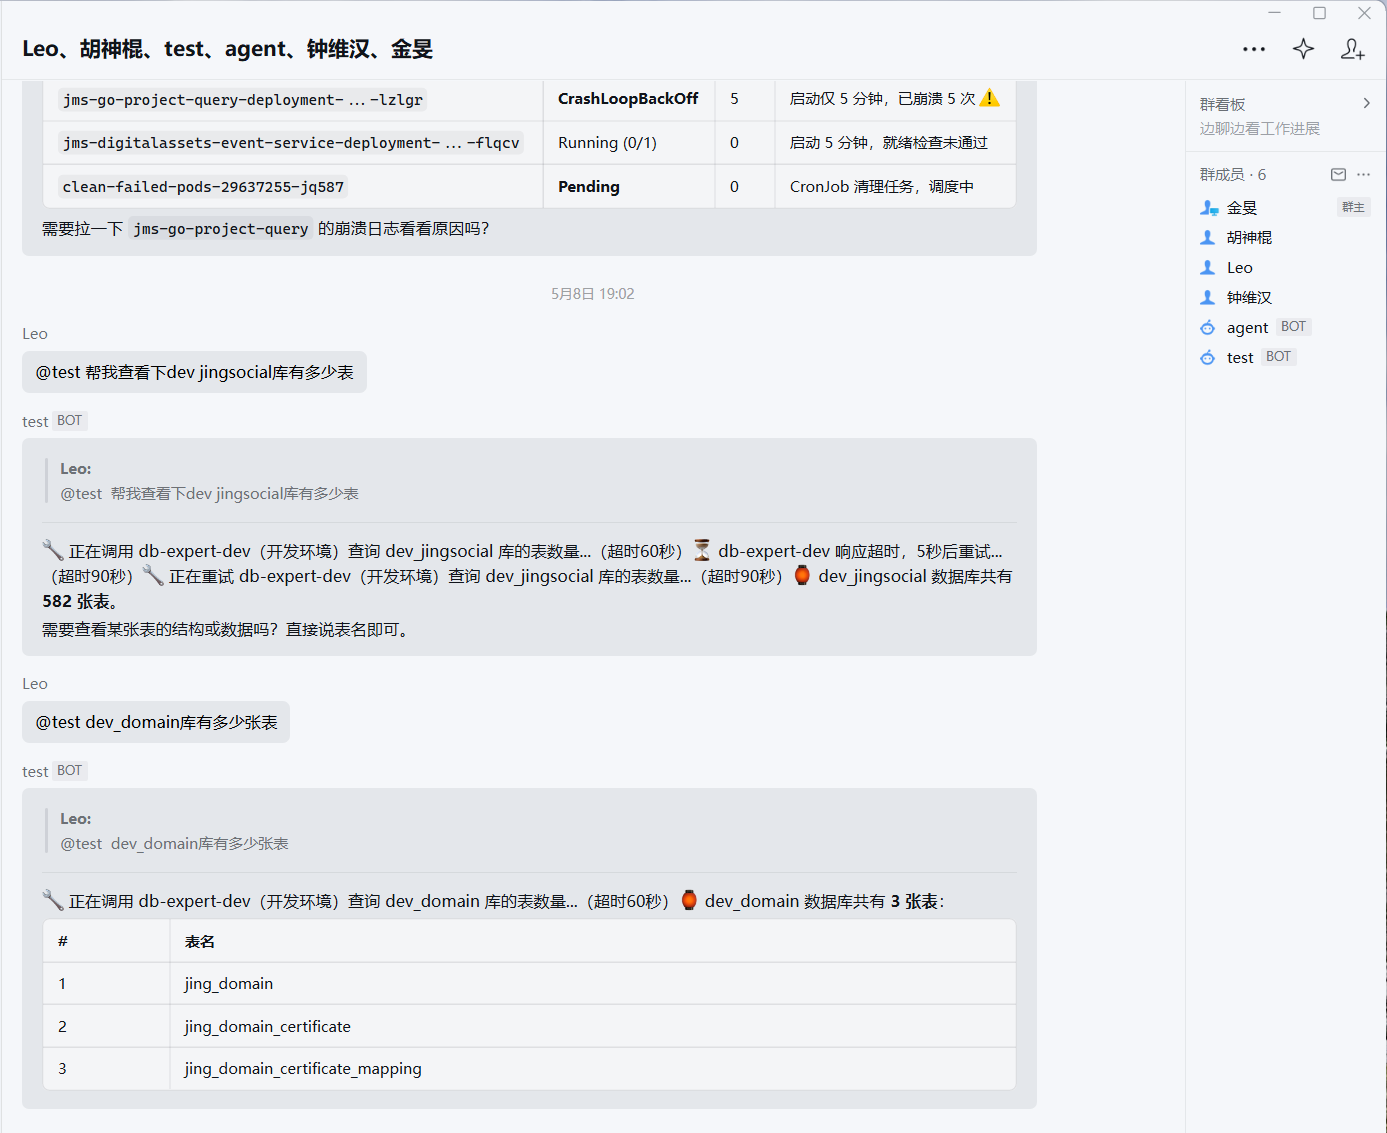
场景 02|K8s 部署状态与数据库表数量查询

复杂任务

一个自然语言输入触发多个工具、多数据源查询,体现 Agent 的多步任务编排能力。

① 用户问题

“帮我查看下 dev_jingsocial 库有多少表 / dev_domain 库有多少张表”

② 用户原来的解决方式

运营找运维查 K8s 状态 → 找研发查数据库表数 → 两个系统分别登录 → 手动汇总信息回复(跨部门沟通耗时 40 分钟+)

③ Agent 如何解决

1意图解析:识别为多目标查询(K8s 状态 + 数据库表数)
2工具路由:并行调度 K8s Tool + Database Tool
3K8s 查询:获取 Pod 列表(CrashLoopBackOff / Running / Pending)
4DB 查询:查询 dev_jingsocial 和 dev_domain 两个库的表数量
5数据聚合:合并多源结果
6LLM 总结:生成结构化自然语言回复
场景 02|K8s 部署状态与数据库表数量查询

④ 为什么这个场景适合 AI

用户只说一句"帮我看看当前环境有没有异常,同时查一下表数量"。这实际是一个多步骤任务:需要时间理解 → 服务识别 → K8s 查询 → 状态判断 → DB 查询 → 结果汇总。传统工具无法用一句话覆盖多个系统,而 Agent 能自动拆解任务、并行调用多个工具。

⑤ 最终结果

dev_jingsocial 库 582 张表;dev_domain 库 3 张表(jing_domain 等);同时展示 K8s Pod 部署状态

多源数据秒级返回 / 一次对话完成跨系统查询

Kubernetes数据库多工具编排复杂任务

12 · 验证迭代阶段

上线后发现的问题

  • 用户习惯难改变:很多人还是习惯直接找研发问,觉得"更靠谱"
  • 查询成功率受数据质量影响:有些数据本身不规范,导致查询结果不准
  • 复杂查询需要多轮澄清:用户一句话说不清楚需求,需要反复追问
  • 权限管理复杂:不同人能看的数据不一样,权限控制是个大问题

13 · 验证迭代阶段

迭代方案

  • 从高频场景切入:先把周报自动化做深做透,用ROI最高的场景建立用户信任
  • 优化查询体验:增加查询结果的可视化呈现,让数据更直观
  • 建立反馈闭环:用户可以对查询结果点赞/点踩,持续优化模型
  • 完善权限体系:对接企业组织架构,实现细粒度的数据访问控制
  • 推广运营:用数据说话,展示节省的时间和效率提升,推动更多人使用

14 · 验证迭代阶段

最终结果

  • 部门周报自动生成:人工整理从 2 小时缩短至 5 分钟
  • 覆盖 5+ 核心查询场景:Git 统计、开发数据、部署状态等
  • 企业微信入口零门槛:运营人员无需培训即可使用
  • 为后续更多 AI 效率场景建立了产品框架和用户习惯

15 · 验证迭代阶段

如果重新做会怎么做

如果重新做,会更重视用户 adoption(采纳率)而非功能数量。第一版做了很多查询能力,但实际高频使用的就两三个。如果重新来,会先聚焦一个最高频的场景(比如周报),把体验做到极致,让用户真正离不开它,然后再扩展其他场景。另外,数据治理是企业AI工具的隐形地基——数据质量不好,再聪明的AI也没用。应该在项目早期就推动数据标准化和规范化的工作。

SUMMARY · 价值与数据

CORE VALUES

核心价值

降低运维门槛

运营人员无需学习 Git CLI、kubectl、SQL 等专业工具,用自然语言就能查询技术数据,真正实现"说一句话就能拿到结果"。

统一操作入口

所有跨系统数据查询都收敛到企业微信一个入口,避免在多个后台之间切换,减少上下文切换成本。

提升响应速度

以往一次数据查询需要找对应研发人员、平均耗时 30 分钟以上;现在大部分查询在 30 秒内返回结果。

数据驱动决策

让运营和产品经理能够自助获取研发数据,把决策从"凭感觉"变成"看数据",提升决策质量。

KEY METRICS

关键数据

4+

典型场景示例

K8s 状态 / Git 仓库 / Pod 健康 / 数据库表数

6+

接入工具数量

Git / Kubernetes / 数据库 / 企业微信 / 脚本 / API

10-50

日均查询次数

试点阶段日均调用量

2-3

使用团队

运营 / 研发 / 产品团队

* 以上为试点阶段真实数据,非正式上线生产环境指标

技术栈

OpenClaw企业微信KubernetesGit数据库
#企业效率#系统集成#自然语言查询